合并京津村界数据:13,868面一条缝
技术专栏 · 数据处理 · 2026-10-23
做京津冀区域图的人迟早会走到这一步:把北京、天津两个村界包并到一张图里。文件层面这只是两个 JSON 的 features 数组拼接,难度为零;真正的悬念藏在两市交界的 70 公里上——两个包各自独立整理,同一条行政界线在两包里是两组不同的采样点,拼上去是严丝合缝,还是裂着一条缝?本文用京津两包实测:13,868 个面,缝确实存在,中位 156 米,逐边配对为零。
拼之前先把两包摆上天平
先看这两份数据各自的分量。溶解之前,能对上的只有坐标系(同为 WGS84)和字段口径;文件体量、要素数、顶点密度都是各走各的:
| 项目 | 北京市包 | 天津市包 |
|---|---|---|
| 村级面要素 | 8,021 | 5,847 |
| 顶点总数 | 1,133,168 | 618,384 |
| gz 压缩体积 | 6.99MB | 3.38MB |
| 溶解耗时(Node 单线程) | 2,566ms | 1,020ms |
| 市域主环顶点 | 31,062 | 33,596 |
| 环方向 | 8,068 环全逆时针 | 401/7,734 顺时针(5.2%) |
有两行值得停下来看。一是天津顶点只有北京的一半多点,溶解出的市域主环却比北京还多 2,500 个顶点——天津的海岸线与海河下游自带锯齿,边界复杂度不与面积或村数成正比。二是环方向:北京 8,068 个环清一色逆时针,天津混进了 401 个顺时针。同一个批次的不同市包尚且如此,从别处拿到的数据更不能对方向做任何假设。
溶解:从 13,868 个小面到两条市界
要量接缝,先把每个市溶成一条轮廓。算法与《从村界聚合出乡镇边界:环缝合实测》同源:登记每条边、共享边相互抵消、剩下的边界边首尾缝合。但直接套用会在京津两包上翻车——第一版按「相邻两面共享边方向必然相反」做定向抵消,北京包溶出了 1,438 条碎链,最长的一条只有 514 个顶点,市域轮廓根本没缝起来。
原因是共享边被同向登记了两次(相邻面自贴边、清洗切缝都会造成),按方向抵消会留下成对的幽灵边界,把主环拦腰截断。改法是不看方向、按无向线段配对,两方向计数相减做净流量,同向偶数次的成对抵消:
// 无向配对 + 净流量抵消:不依赖环方向约定
const pairs = new Map();                       // 无向键 -> {有向键: 次数}
for (const f of feats) for (const ring of ringsOf(f)) {
  for (let i = 0; i < ring.length - 1; i++) {
    const a = ring[i], b = ring[i + 1];
    const ka = q(a[0]) + ',' + q(a[1]), kb = q(b[0]) + ',' + q(b[1]);
    const und = ka < kb ? ka + '|' + kb : kb + '|' + ka;
    const m = pairs.get(und) || new Map();
    m.set(ka + '>' + kb, (m.get(ka + '>' + kb) || 0) + 1);
    pairs.set(und, m);
  }
}
const boundary = [];
for (const [, m] of pairs) {
  if (m.size === 1) {                          // 只有一个方向:奇数次留 1,偶数次全消
    const [, n] = [...m][0];
    if (n % 2) boundary.push([...m.keys()][0]);
  } else {                                     // 双方向都有:计数相减,留多数方向
    const [[d1, n1], [d2, n2]] = [...m];
    if (n1 !== n2) boundary.push(n1 > n2 ? d1 : d2);
  }
}
改完之后两市一次缝成:北京 45,472 条边界边汇出主环 31,062 顶点(另有 1,262 个洞环与碎环,主要是水库水面与街坊细缝),天津 36,840 条边界边汇出主环 33,596 顶点(28 个次环)。两条轮廓叠到一起,北京市界与天津市界在东南方向贴出一条 70 公里的接触带。
接缝实测:贴着走,但不是一条线
把两条轮廓放进同一个坐标系,先做最苛刻的检验——逐边配对。把天津边界按不同地面精度量化建反向边集合,再看北京边界有多少条能对上:
| 量化精度 | ≈地面距离 | 配对边数 |
|---|---|---|
| 1e-6 度 | 约 0.1 米 | 0 |
| 1e-5 度 | 约 1.1 米 | 0 |
| 1e-4 度 | 约 11 米 | 25 |
0.1 米和 1.1 米精度下配对数都是零——两市边界没有共用过任何一个顶点。放宽到 11 米也只找回 25 条边。放大到局部看得更清楚,两条线一路相伴,但始终是两条线:
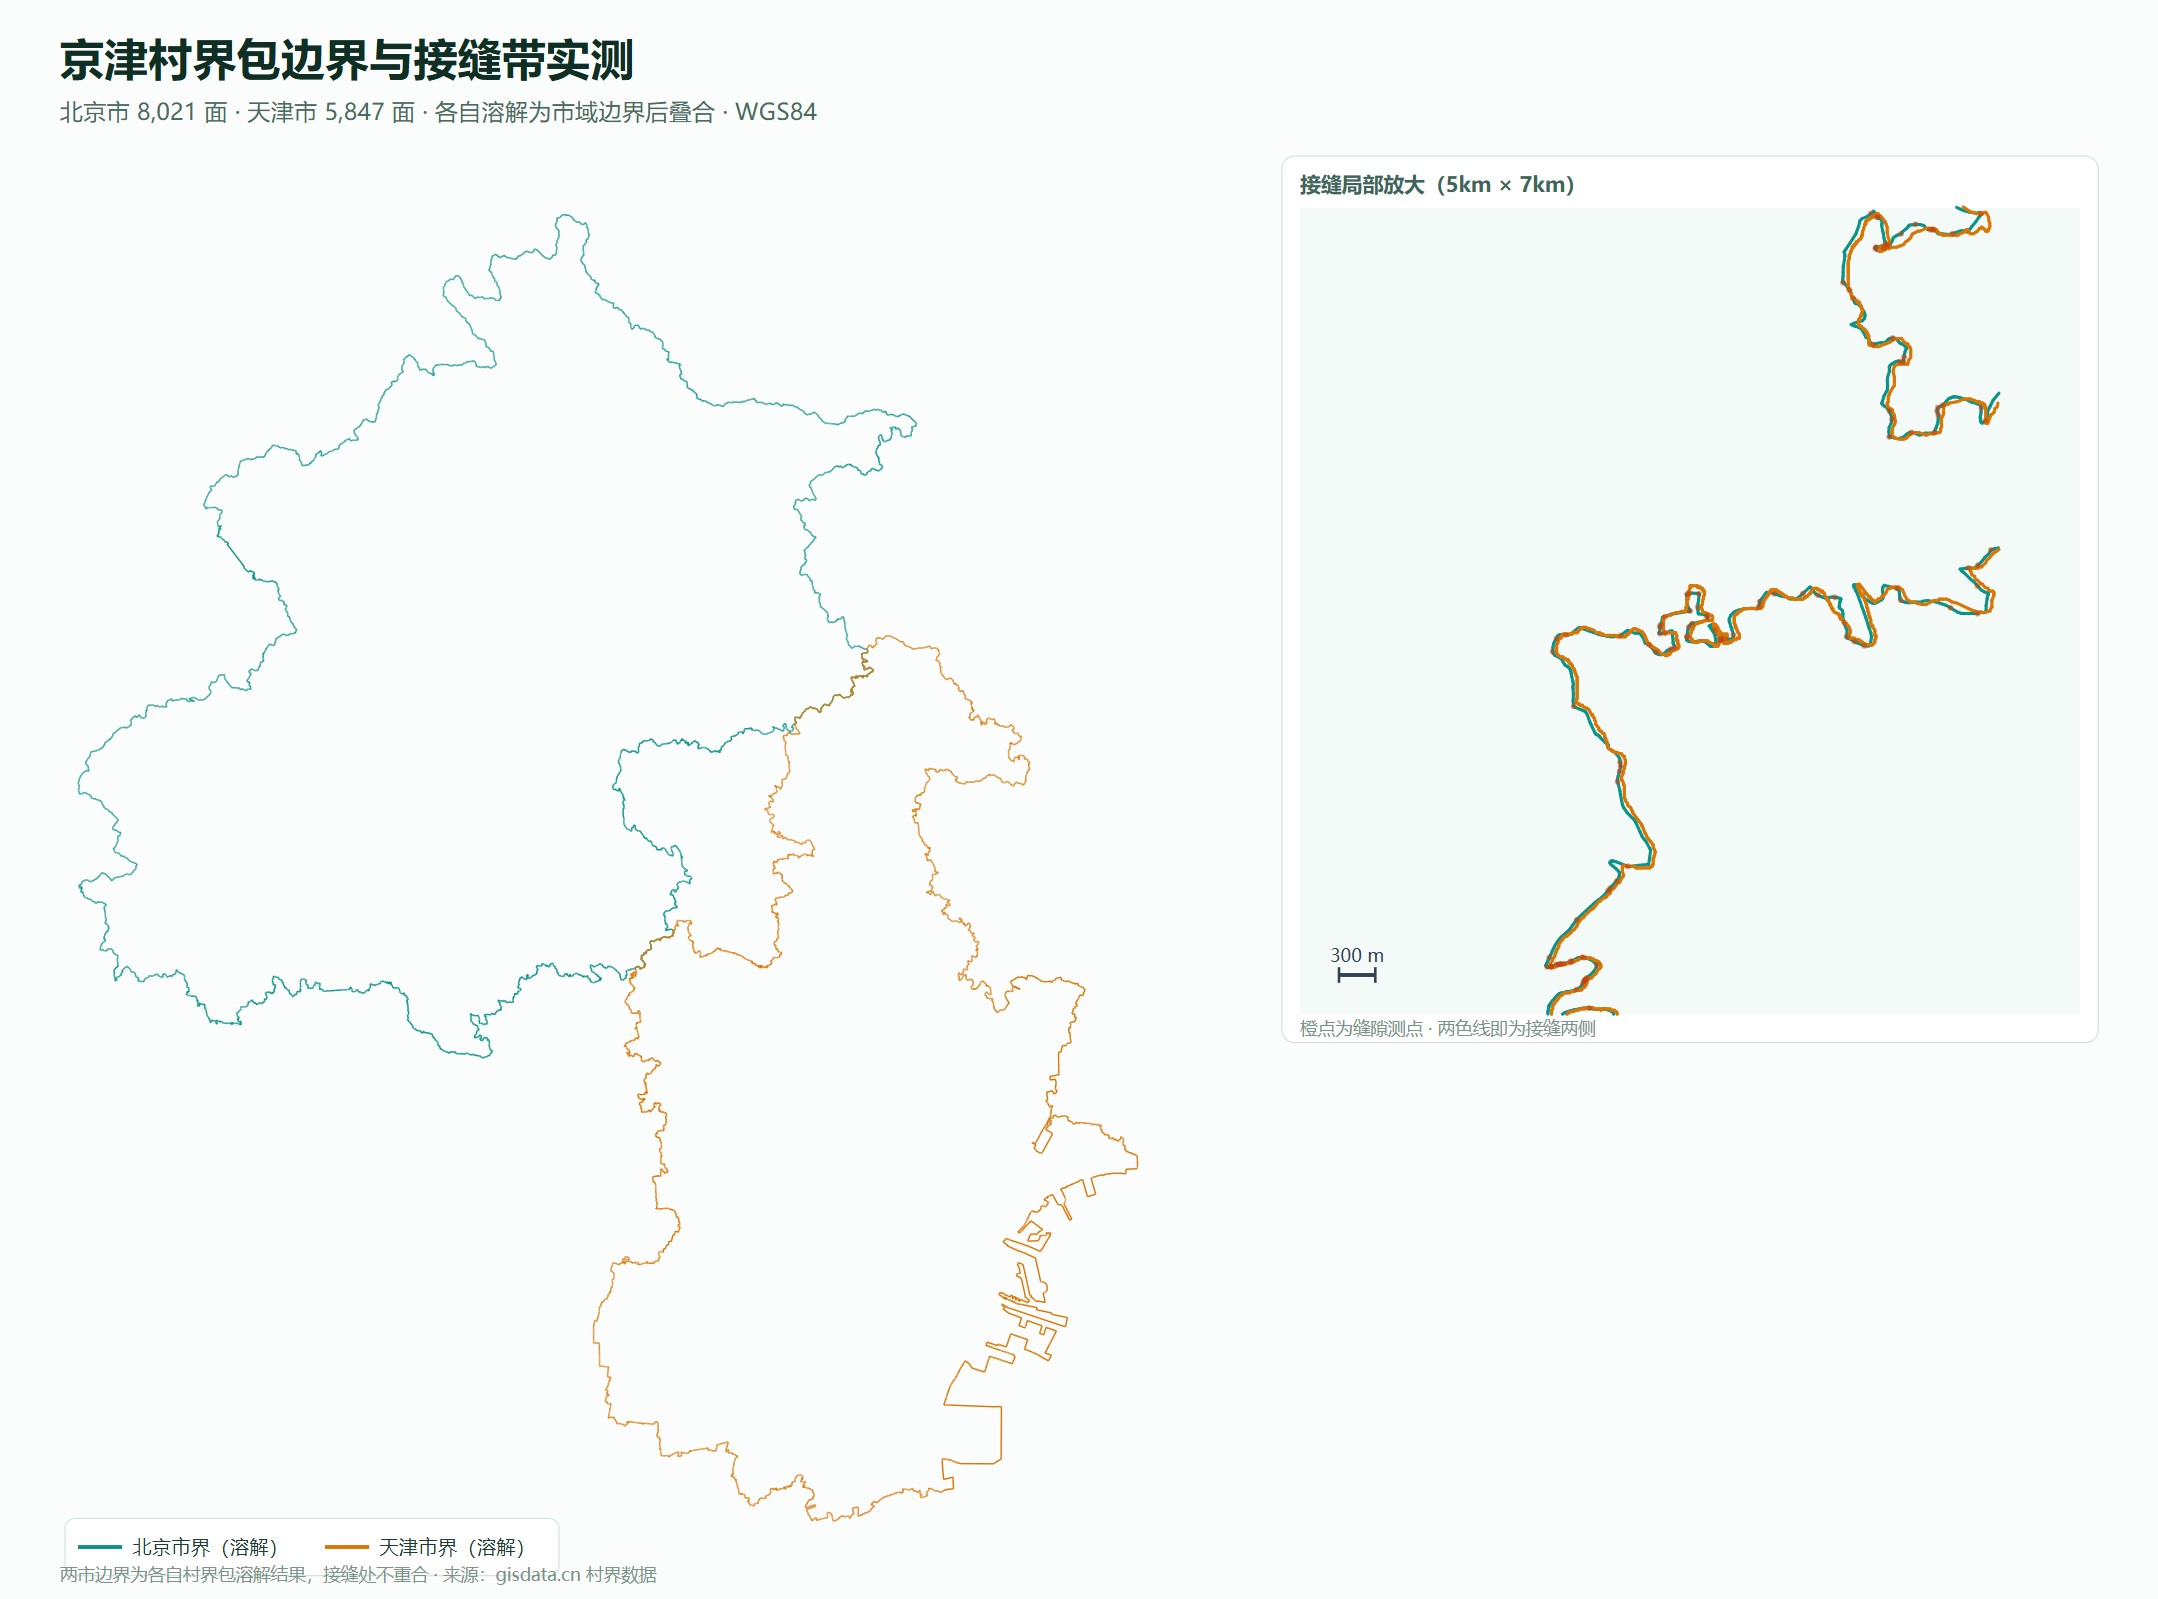
再把缝量化成距离。以北京市界的 11,476 个边界顶点为测点(限两市接触带),逐一算到天津市界最近线段的距离,其中 7,596 个点落在天津市界 5 公里以内、属于真接缝样本:
| 样本口径 | 测点数 | 中位 | p90 | p95 |
|---|---|---|---|---|
| 距津界 1km 以内 | 5,716 | 108 米 | 282 米 | 674 米 |
| 距津界 5km 以内 | 7,596 | 156 米 | 2,588 米 | 3,687 米 |
真接缝带上,一半的测点离对面边界不到 110 到 156 米,九成在 300 米内;5 公里口径下 p90 跳到 2.6 公里,那不是缝宽了,是北京边界在平谷以北转去接河北、测点几何上仍靠近天津被扫了进来。另一个细节:11 米量化配对出的 25 条边,集中在两市与河北交界的三节点一带——那里更像有共同的界桩坐标,其余 70 公里全是各走各的采样。1 公里内的最大缝隙约 999 米,出现在界线急剧转折处。
这条缝怎么办:分场景处理
缝要不要紧,取决于图用来干什么。做底图和填色图:不用管。156 米在市级尺度上小于一个像素,两条线各自画各自的颜色,视觉上是无缝的一张图。做跨市统计:先想清楚缝间的地带算谁的。按村面统计天然不受影响(每个面带属性),但做「距边界 500 米缓冲区」这类分析时,两市各算各的会在缝上漏出一条无人认领的地带。做邻接与拓扑:必须先处理,把两条边界线合并成一条共享边,或者接受邻接判断在缝上失效。
检测脚本本身很轻:天津边建网格索引(0.005° 格),北京边界顶点逐点到最近线段求距离,1.1 万个测点几秒跑完。把它加进《边界数据拓扑检查:一段脚本查出缝隙与重叠》的流程里,任何两个包拼接后都值得跑一遍——缝是常态,量过才踏实。缝隙的米数怎么从度数换算,见《经纬度一格多少米:五份村界包换算实测》。
合并体量:9.79MB 的合并包怎么用
两市 features 直接拼接,13,868 个面序列化后 40.1MB,gzip 后 9.79MB,序列化耗时约 2 秒。桌面 GIS 直接拖入没问题;Web 端别把 40MB 的 JSON 推给浏览器——按当前视野裁剪、或按区县拆成按需加载的小块,是《村界数据怎么下钻:从全市到单县的加载实测》里验证过的路子。真要整包上线,gz 传输 9.79MB 加上解析,请给加载态留足耐心。
北京、天津两包出自同一批次,字段口径一致(北京的区县字段为空、按村级码前缀归并的方法见《做成北京村界地图:8,021个村级面一包拿齐》),合并后做京津冀联动分析不需要再对字段。两个包都在「村界数据 · 按市」页按市取用;河北 11 市同页可取,或用「村界数据 · 按省」的河北整包一次拿齐。
常见问题
- 不同市的村界包能直接拼成区域图吗?
- 能。两个 FeatureCollection 的 features 数组拼起来就是一个可用的合并图层,画图立刻见效。但本文实测北京、天津两市包的接缝逐边配对为零、中位缝隙 156 米——画底图看不出,做跨市统计、邻接分析前要先把这条缝处理掉。
- 合并后的文件有多大?浏览器能直接加载吗?
- 北京加天津 13,868 个面,序列化后 JSON 约 40.1MB,gzip 压缩 9.79MB,桌面 GIS 毫无压力;浏览器端全量加载会卡,建议按当前视野裁剪或先抽稀再上线,坐标精度与体积的取舍方法见站内《GeoJSON 太大?先抽点,再谈小数位》。
- 两市边界为什么对不上?是数据错了吗?
- 不是错,是采样路径不同。同一条约 70 公里的行政界线,两包各自带着本包内的村界走,边界顶点的位置和间距都不一样:按 0.1 米和 1.1 米量化逐边配对都是 0 条,11 米也只有 25 条。两包各自内部拓扑干净(面无缝无重叠),缝只出现在两包相接的那一带。
- 合并和溶解是一回事吗?
- 不是。合并是把多个包的要素并成一个文件,面还是那些面;溶解是把相邻面的共享边消掉、聚合成大面。做区域底图要的是合并(保留村界细节),做市级轮廓、区域填色要的是先各自溶解再叠合。本文的溶解脚本与《从村界聚合出乡镇边界:环缝合实测》同源。
- 环方向不一致会导致什么问题?
- 不少工具假设外环逆时针、内环顺时针,用符号面积判断内外环。实测天津包 7,734 个环里有 401 个顺时针(5.2%),北京包则全部逆时针——别对任何包做方向假设。依赖方向约定的溶解算法在天津包上会漏消共享边,本文改用无向配对后两市主环都一次缝成。
- 拼京津冀全区域还需要什么数据?
- 京津冀等于北京加天津加河北:北京、天津用按市村界包,河北的 11 个地市可以逐市取按市包,或直接拿河北按省整包一次到位,三份数据同批次同口径、坐标系一致。拼接流程与本文相同:先合并、再对每对新接缝跑一遍检测脚本。