9万个村面的瘦身普查:24包全量实测
技术专栏 · 数据处理 · 2026-11-07
《把村界地图搬上网页》那篇用两份包验证了瘦身管线的可行性,留言里被问得最多的是:别的包收益也这么大吗?这次把在售的 24 个市包、90,761 个村级面全部过一遍统一管线——量化 1e-5、TopoJSON 编码、brotli 压缩——每包记录体积与面积误差,逐包账单、分档结论都在这篇里。
总账:209.9MB 压到 39.2MB
24 包的原始 gz 合计 209.9MB,管线终点 brotli 合计 39.2MB,整体压缩 5.4 倍;折算到每个村级面,管线终体积约 0.43KB。逐包看,压缩比从 2.4 倍到 9.2 倍不等,分化明显——这正是普查要回答的问题:收益不是均匀的,它取决于原包有多「虚胖」。
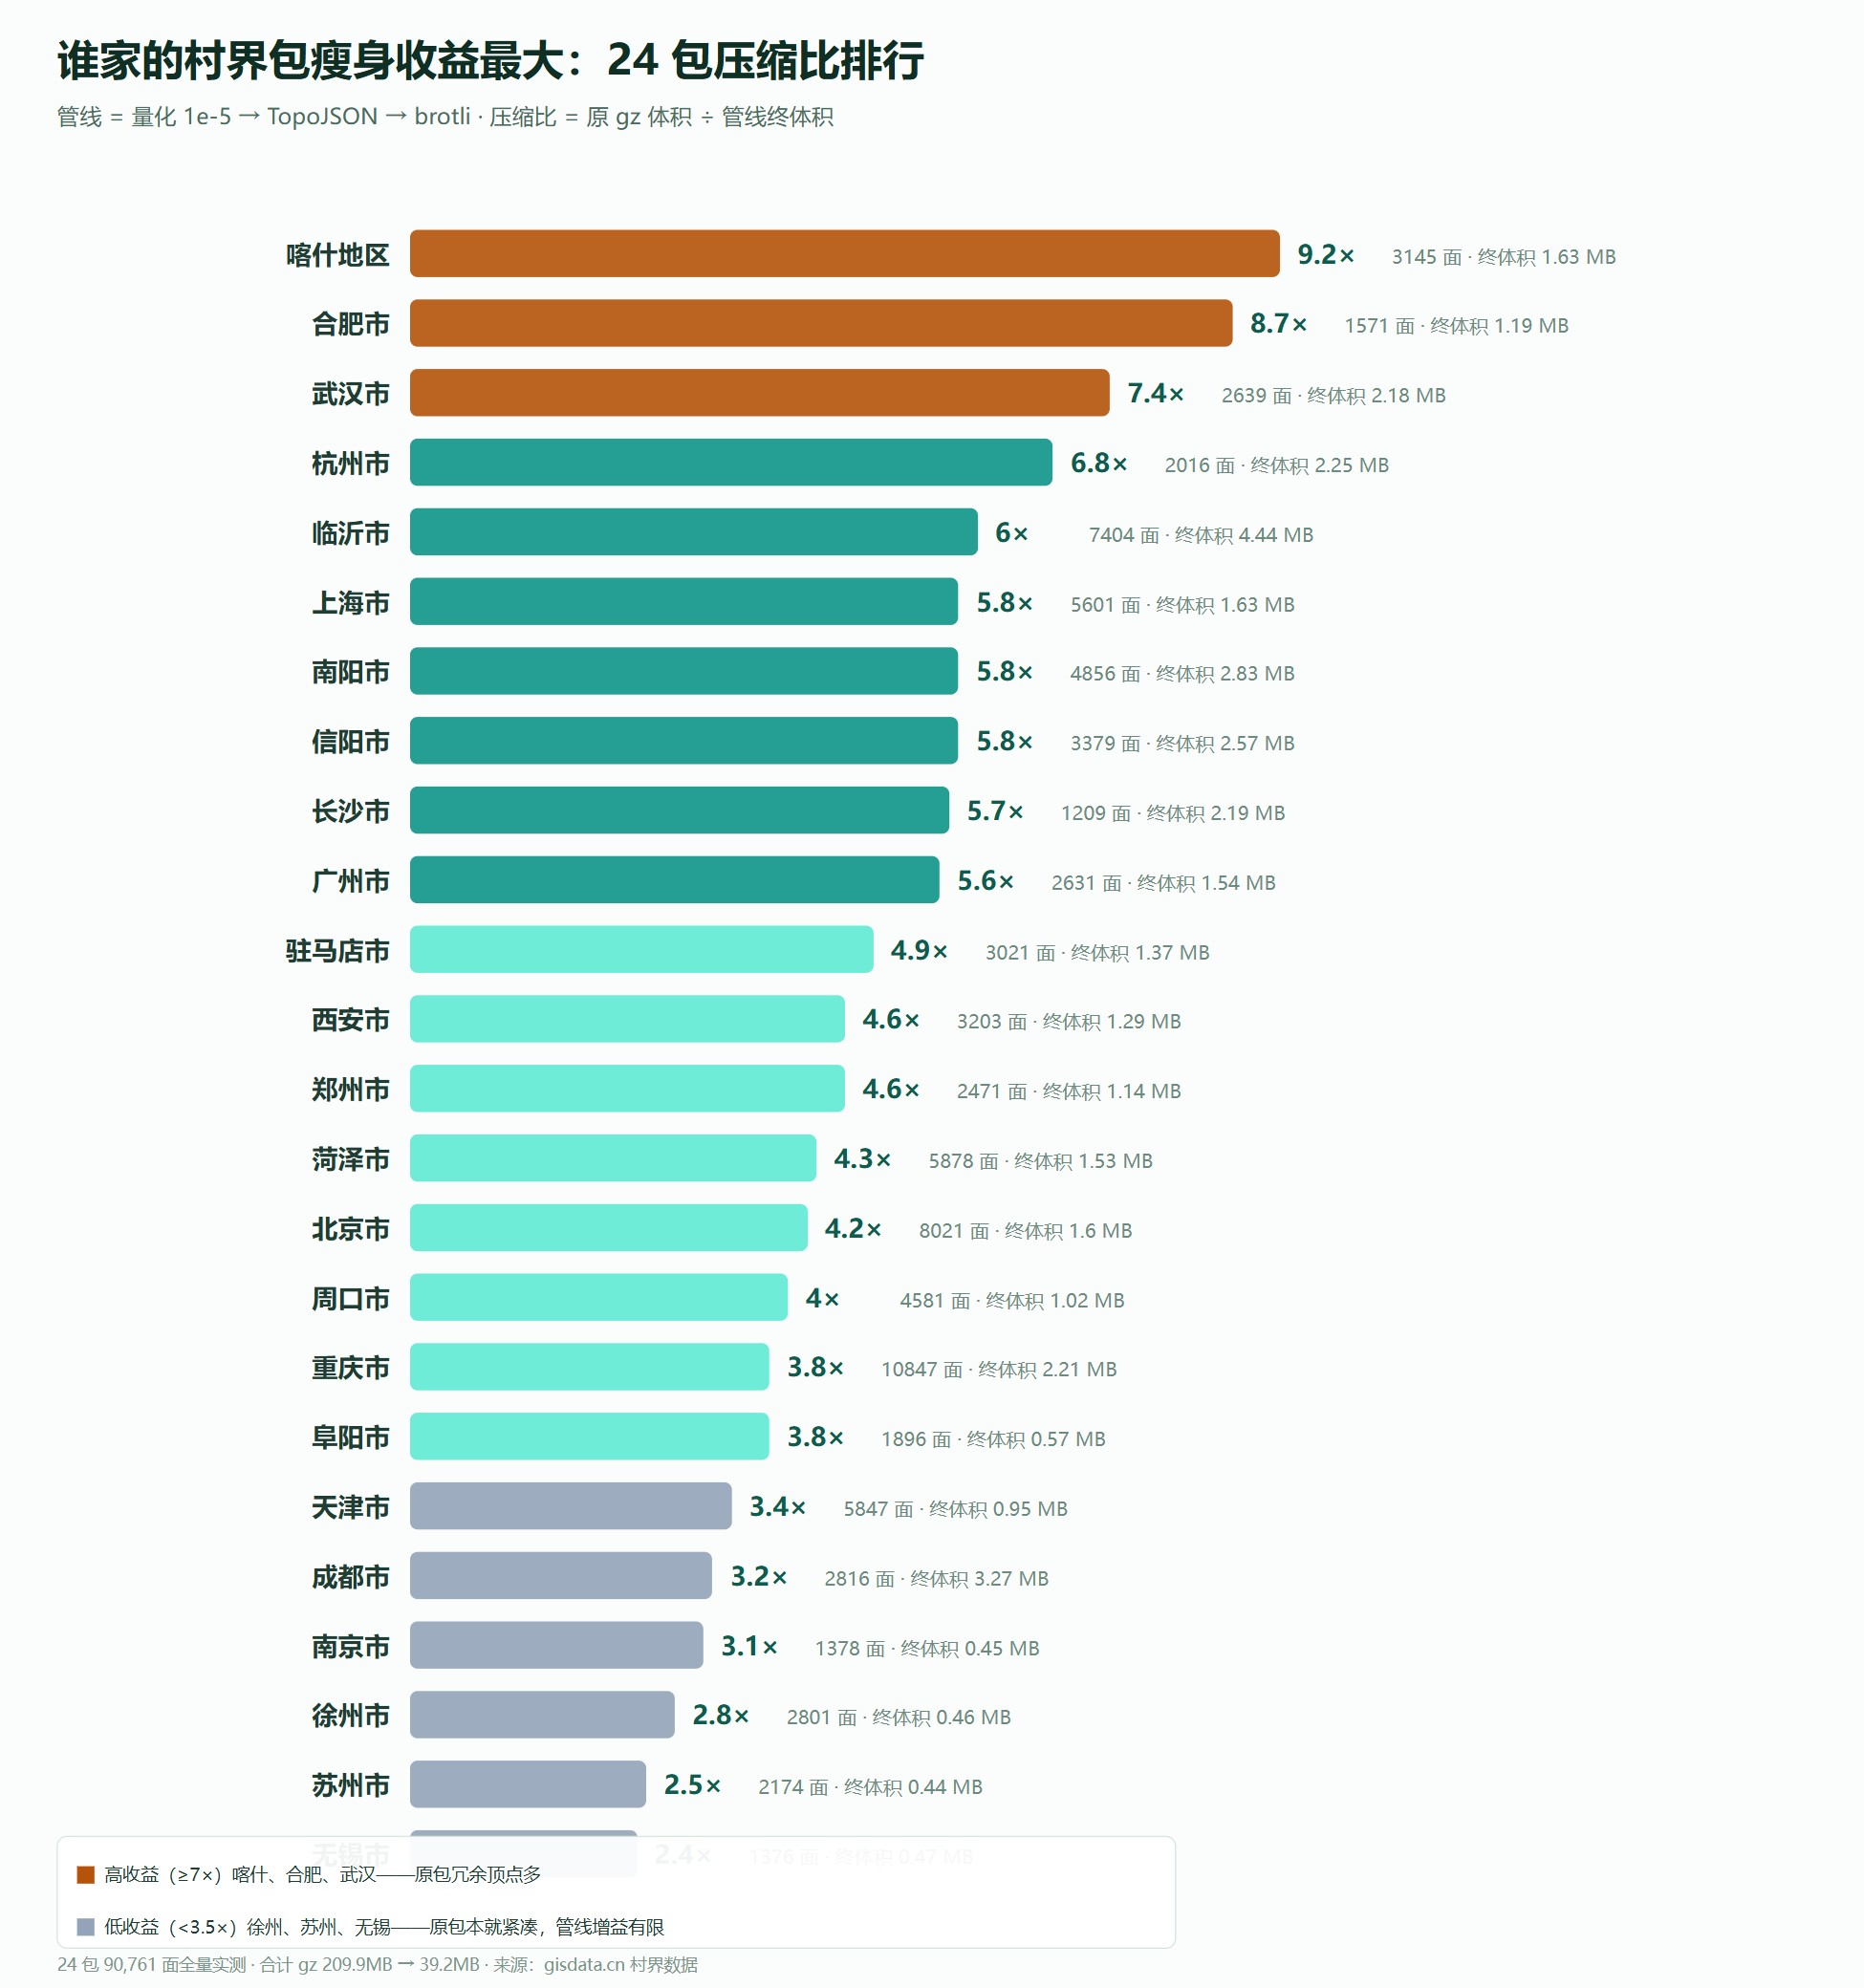
分档结论:谁收益最大,谁本来就该轻
| 档位 | 市包(压缩比) | 共同特征 |
|---|---|---|
| 高收益 ≥7× | 喀什 9.2 · 合肥 8.7 · 武汉 7.4 | 顶点冗余大:山区碎面、全字段满包 |
| 中收益 4–7× | 临沂 6.0 · 杭州 6.8 · 上海 5.8 · 信阳 5.8 · 南阳 5.8 · 长沙 5.7 等 11 包 | 平原丘陵混合,管线主力区间 |
| 低收益 <3.5× | 徐州 2.8 · 苏州 2.5 · 无锡 2.4 · 南京 3.1 · 天津 3.4 | 原包紧凑或面数少,底价占比高 |
高收益档(压缩比 ≥ 7 倍):喀什 9.2、合肥 8.7、武汉 7.4。喀什的原包顶点密度冠绝全站——帕米尔村界沿山脊河谷逐弯记录,冗余顶点最多,量化与弧段共享的削剪空间最大。合肥是「全字段满」的平原包,冗余来自平原村界的密集折点。
中间档(4 到 7 倍):临沂、杭州、上海、南阳、信阳、长沙等 11 包。多数平原与丘陵混合市的落点,管线后单包体积收敛到 0.5 到 4.5MB。
低收益档(< 3.5 倍):徐州 2.8、苏州 2.5、无锡 2.4、南京 3.1。这四包原包本身就紧凑——徐州村级面平均只有 2KB,坐标本就稀疏;苏州无锡的组织全称包形态规整。对它们,管线的价值不是压体积,而是顺手完成量化与拓扑化,为 Web 端 TopoJSON 直读做准备。
误差复核:全部在可用区
24 包逐包对比量化前后逐面面积:误差中位最小的长沙市只有 0.002%,最大的上海 0.034%——上海的「区内镇外」兜底面与街坊碎面是全市误差的主要贡献者。全部 24 包的中位误差都不超过万分之三点四,按一个 3 平方公里的村算,中位误差不到 1 平方米。村级统计、分档渲染、区域汇总都可放心;测绘级计算仍然建议用原始包。
一个反直觉的发现:小包有「管线底价」
24 包里最小的无锡(1,376 面),管线终体积 0.47MB;最大的临沂(7,404 面),终体积 4.44MB——体积大体随面数线性走,但线性拟合的截距明显为正:再小的市包,过完管线也有约 0.4 到 0.5MB 的「底价」,那是 TopoJSON 的元数据、量化变换参数与属性表的地板体积。想压到几十 KB,只能靠裁剪范围或抽稀,管线本身有下限。这也解释了为什么单县包才是 Web 端的最佳交付粒度。
脚本:一次遍历出全部账单
import { gunzipSync, gzipSync, brotliCompressSync } from 'node:zlib';
import { createRequire } from 'node:module';
const require = createRequire(import.meta.url);
const { topology } = require('topojson-server');

for (const cname of CITIES) {
  const raw = gunzipSync(readFileSync(`data/village/市/${cname}_村界_WGS84.geojson.gz`));
  const feats = JSON.parse(raw).features;
  const topo = topology({ villages: { type: 'FeatureCollection', features: feats } }, 1e5);
  const buf = Buffer.from(JSON.stringify(topo));
  const br = brotliCompressSync(buf, { params: { 1: 5 } });   // q5:秒级实用档
  console.log(city, '面', feats.length, '→ brotli', (br.length / 1048576).toFixed(2), 'MB');
}
这套普查的账单本身就是选型指南:按需查自己城市的行,就知道量化后多大、TopoJSON 多大、压缩后多大。24 个市的村界包在「村界数据 · 按市」页按市整包出售,省级批量走「村界数据 · 按省」整包。
常见问题
- 这次普查的口径是什么?
- 24 个在售市级包、90,761 个村级面全量过一遍统一管线:坐标量化到 1e-5(约 1.1 米)、topojson-server 编码成 TopoJSON(内建同档量化)、brotli 压缩。每包记录原始体积、管线各段体积与面积误差,全部账单在文内表格中。
- 整体瘦身效果怎么样?
- 24 包原始 gz 合计 209.9MB,管线终点 brotli 合计 39.2MB,整体压缩 5.4 倍;逐包压缩比从 2.4 倍到 9.2 倍不等。面积误差中位全部在 0.002% 到 0.034% 之间,做村级统计与分档渲染完全够用。
- 为什么有的包压缩收益特别大?
- 收益与原包的顶点冗余度相关:喀什的山区村面顶点密、量化后坐标大量重复,TopoJSON 的弧段共享再削一刀,压缩比达 9.2 倍;徐州、苏州、无锡的包原本就紧凑,比值只有 2.4 到 2.8。原包越「虚胖」,这套管线收益越大。
- 为什么压缩用 brotli q5 而不是最高档?
- 上篇实测过:46MB 原串用 brotli 最高档 q11 压缩要 281.6 秒,只适合离线预压静态文件。这次普查改用 q5——秒级完成、体积与 gzip 最高档相当。动态接口压缩推荐 q5,静态资源预压再上 q11。
- 面积误差会不会影响村级统计?
- 24 包的面积误差中位全部落在 0.002% 到 0.034% 之间,按一个 3 平方公里的村计算,中位误差不到 1 平方米。村级统计、分档渲染、区域汇总都够用;测绘级精度场景仍建议用原始包在桌面 GIS 里计算。
- 这些市包和瘦身脚本在哪里能拿到?
- 24 个市的村界包都在「村界数据 · 按市」页按市整包出售,省级批量走「村界数据 · 按省」整包;量化、TopoJSON 编码与 brotli 压缩的脚本本文已给出,Node 环境直接复用。