GeoJSON 太大?先抽点,再谈小数位
技术专栏 · 数据处理 · 2026-10-10
手里一个解压后 40.76MB 的 GeoJSON,要塞进浏览器。「把坐标砍到 3 位小数」大概率是第一个冒出来的念头——这轮实测过后,结论要倒过来:先把点抽掉,小数位是最后才动的东西。样本就是本文所属站点的成都市村界包:2,816 个村级面,184 万个坐标点,外加挪威一级区划(53 万个点、绵长海岸线)做对照,全部数字来自本轮实际运行。
先算点数账:体积大头根本不是小数位
成都包里每个村平均带 656 个点,184 万个点以「[104.092998,30.594919]」这样的文本重复 184 万次,才是 40.76MB 的来源。小数位对体积的贡献很容易高估——实测这份包的 184 万个纬度值里,只有 10% 的第 6 位小数是 0、1% 末两位同时是 0。也就是说数据源真的用满了 6 位精度,「去掉无效零白拿体积」这种便宜在这份数据上不存在,动精度就必然动误差。
顺带把挪威那份数据也查了:53 万个点,第 6 位小数为 0 的占 12.8%。两份数据一个村级一个国家级,结论一致:想省体积就得接受误差。
降小数位:JSON 省得少,gz 省得多
把全部坐标四舍五入到 d 位小数重新序列化,逐档实测(纬度 30.8° 附近,经向 1 个小数位对应约 9.5 米):解压后的 JSON 从 40.76MB 到 30.19MB,只省 26%;同样的文件 gz 压缩后从 10.18MB 掉到 1.22MB,省 88%。量化把坐标「钉」到整齐的栅格上,相邻点大量取相同值,压缩器的字典匹配效率暴涨——这就是 gz 口径下小数位收益被放大的机制。
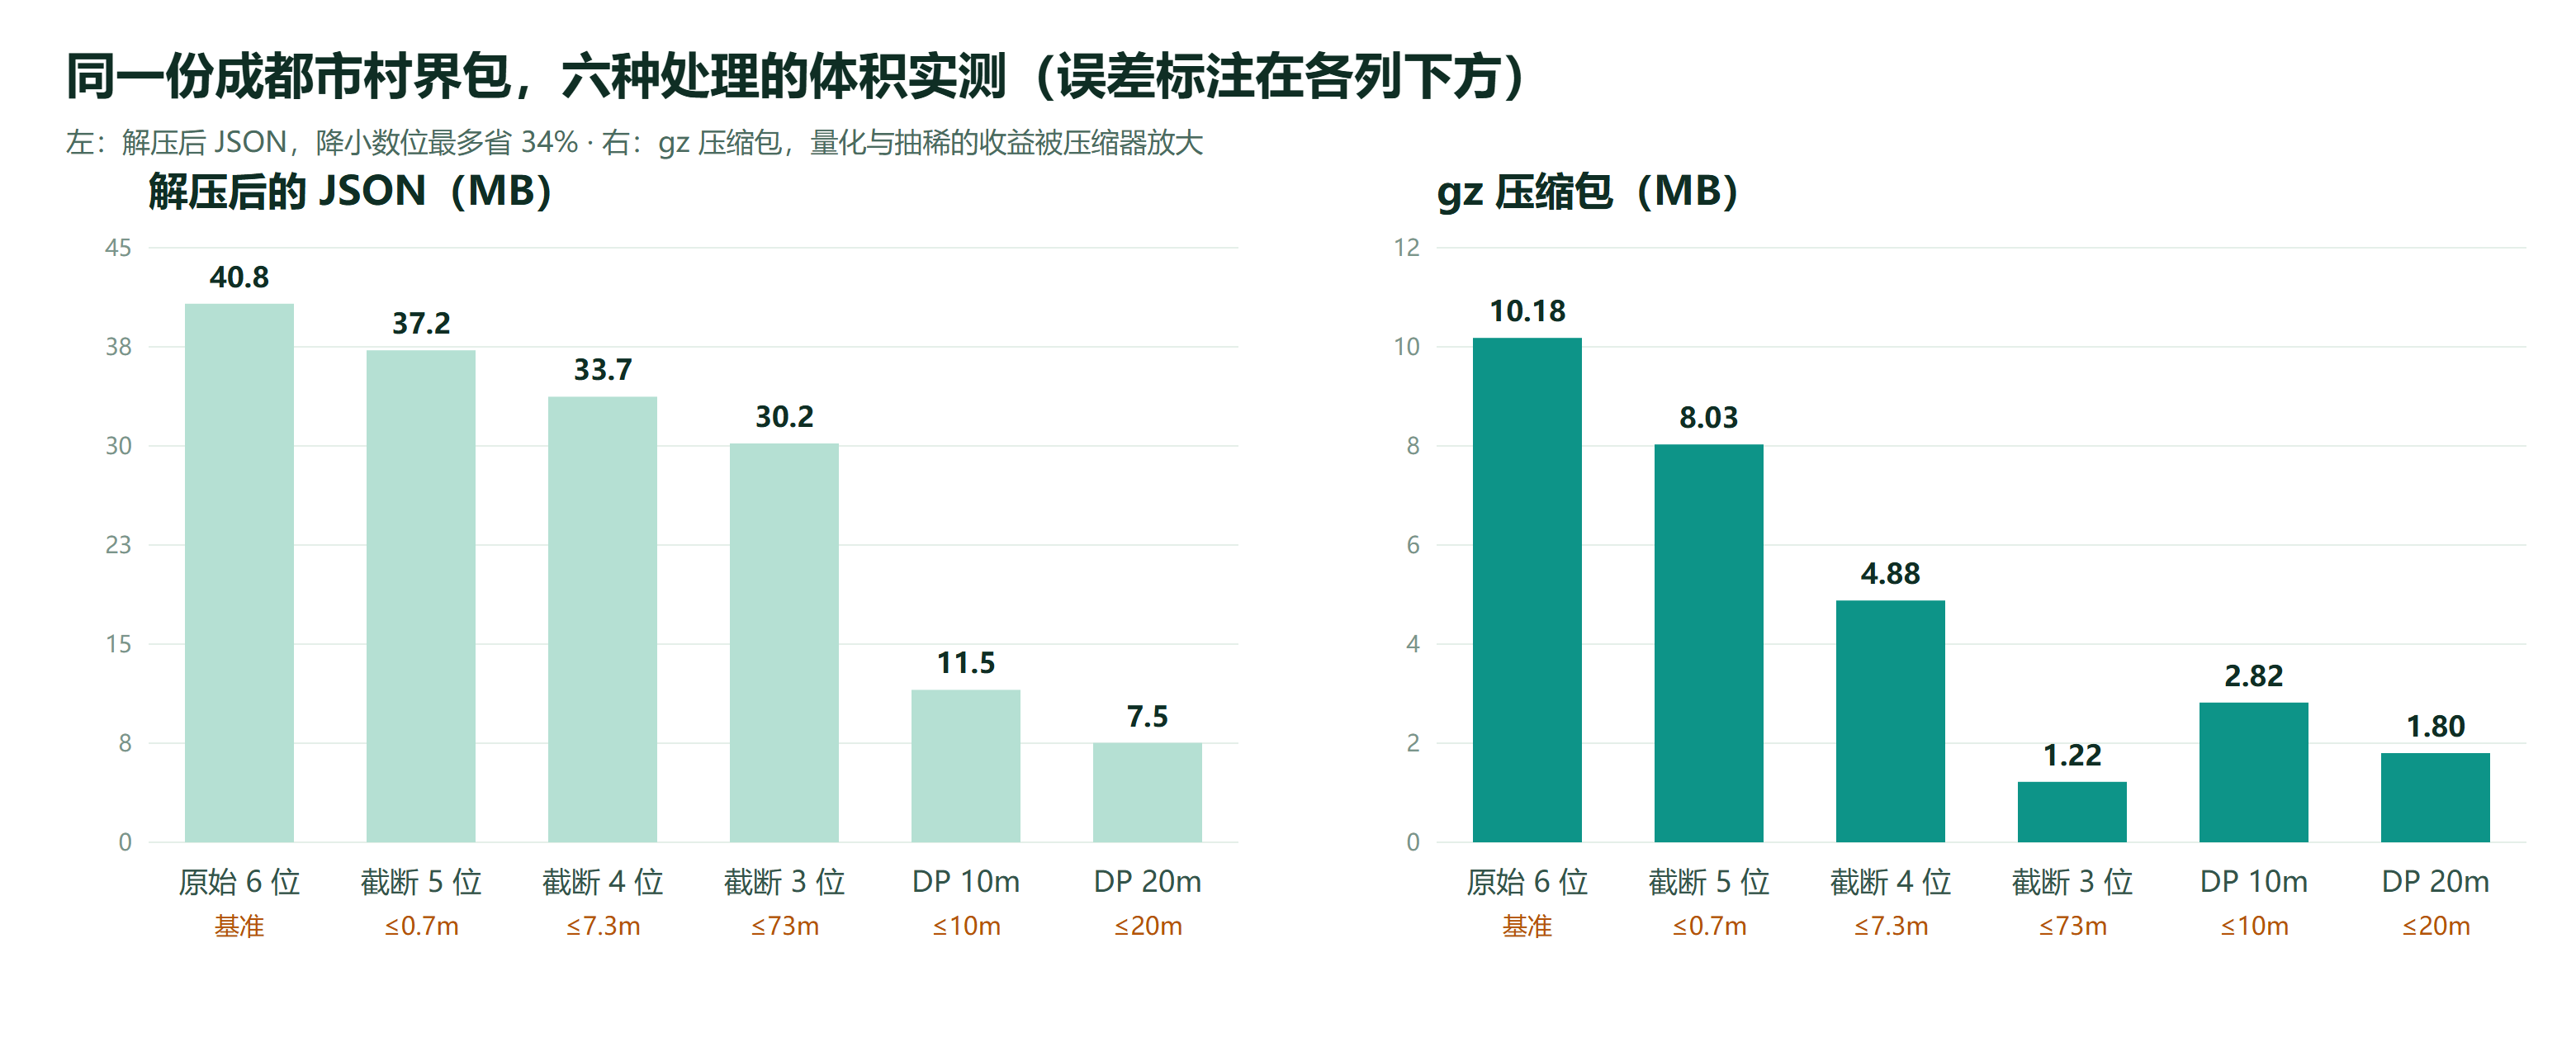
| 样本 | 处理 | JSON (MB) | gz (MB) | 最大偏移 | 平均偏移 |
|---|---|---|---|---|---|
| 成都市村界(185 万点) | 原始 6 位(基准) | 40.76 | 10.18 | — | — |
| 截断 5 位 | 37.24 | 8.03 | 0.7 m | 0.4 m | |
| 截断 4 位 | 33.72 | 4.88 | 7.3 m | 4.0 m | |
| 截断 3 位 | 30.19 | 1.22 | 73.1 m | 39.5 m | |
| 截断 2 位 | 26.67 | 0.24 | 730 m | 393 m | |
| 挪威一级区划(53 万点) | 原始 6 位(基准) | 10.70 | 2.02 | — | — |
| 截断 4 位 | 8.79 | 1.69 | 6.0 m | 3.2 m | |
| 截断 3 位 | 7.75 | 1.07 | 60.2 m | 31.8 m |
误差的账很好记:每降 1 位小数,最大偏移放大 10 倍。4 位对应 7 米量级——村界制图、Web 展示都安全;3 位对应 73 米——行政村本身的边界带宽就只有几十米,这个误差会把面积统计带偏,做分析不能要;2 位对应 730 米,栅格间距约 955 米,比下面那张放大图的整个窗口还宽。
抽稀是另一件事:删点,但保形
道格拉斯-普克(DP)按容差删掉「不在拐弯处」的点,保留下来的点一个都不挪。成都包实测:10 米容差删掉 72.8% 的点(gz 省 72%),20 米容差删掉 82.9%(gz 10.18 → 1.80MB,省 82%)。挪威数据在 2~10 米容差下几乎删不动(保留 72%),20 米才见效——它的点本来就稀,印证了「数据密才谈得上抽」。
降小数位挪点、抽稀删点,放大看差异一目了然。同一段都江堰村界(约 850 米宽的窗口):3 位小数出现明显的直角楼梯;2 位小数整个窗口比栅格间距还小,45 个点被压成一条远偏离原位的直线;DP 20m 只留 4 个点,形状还贴着原线。
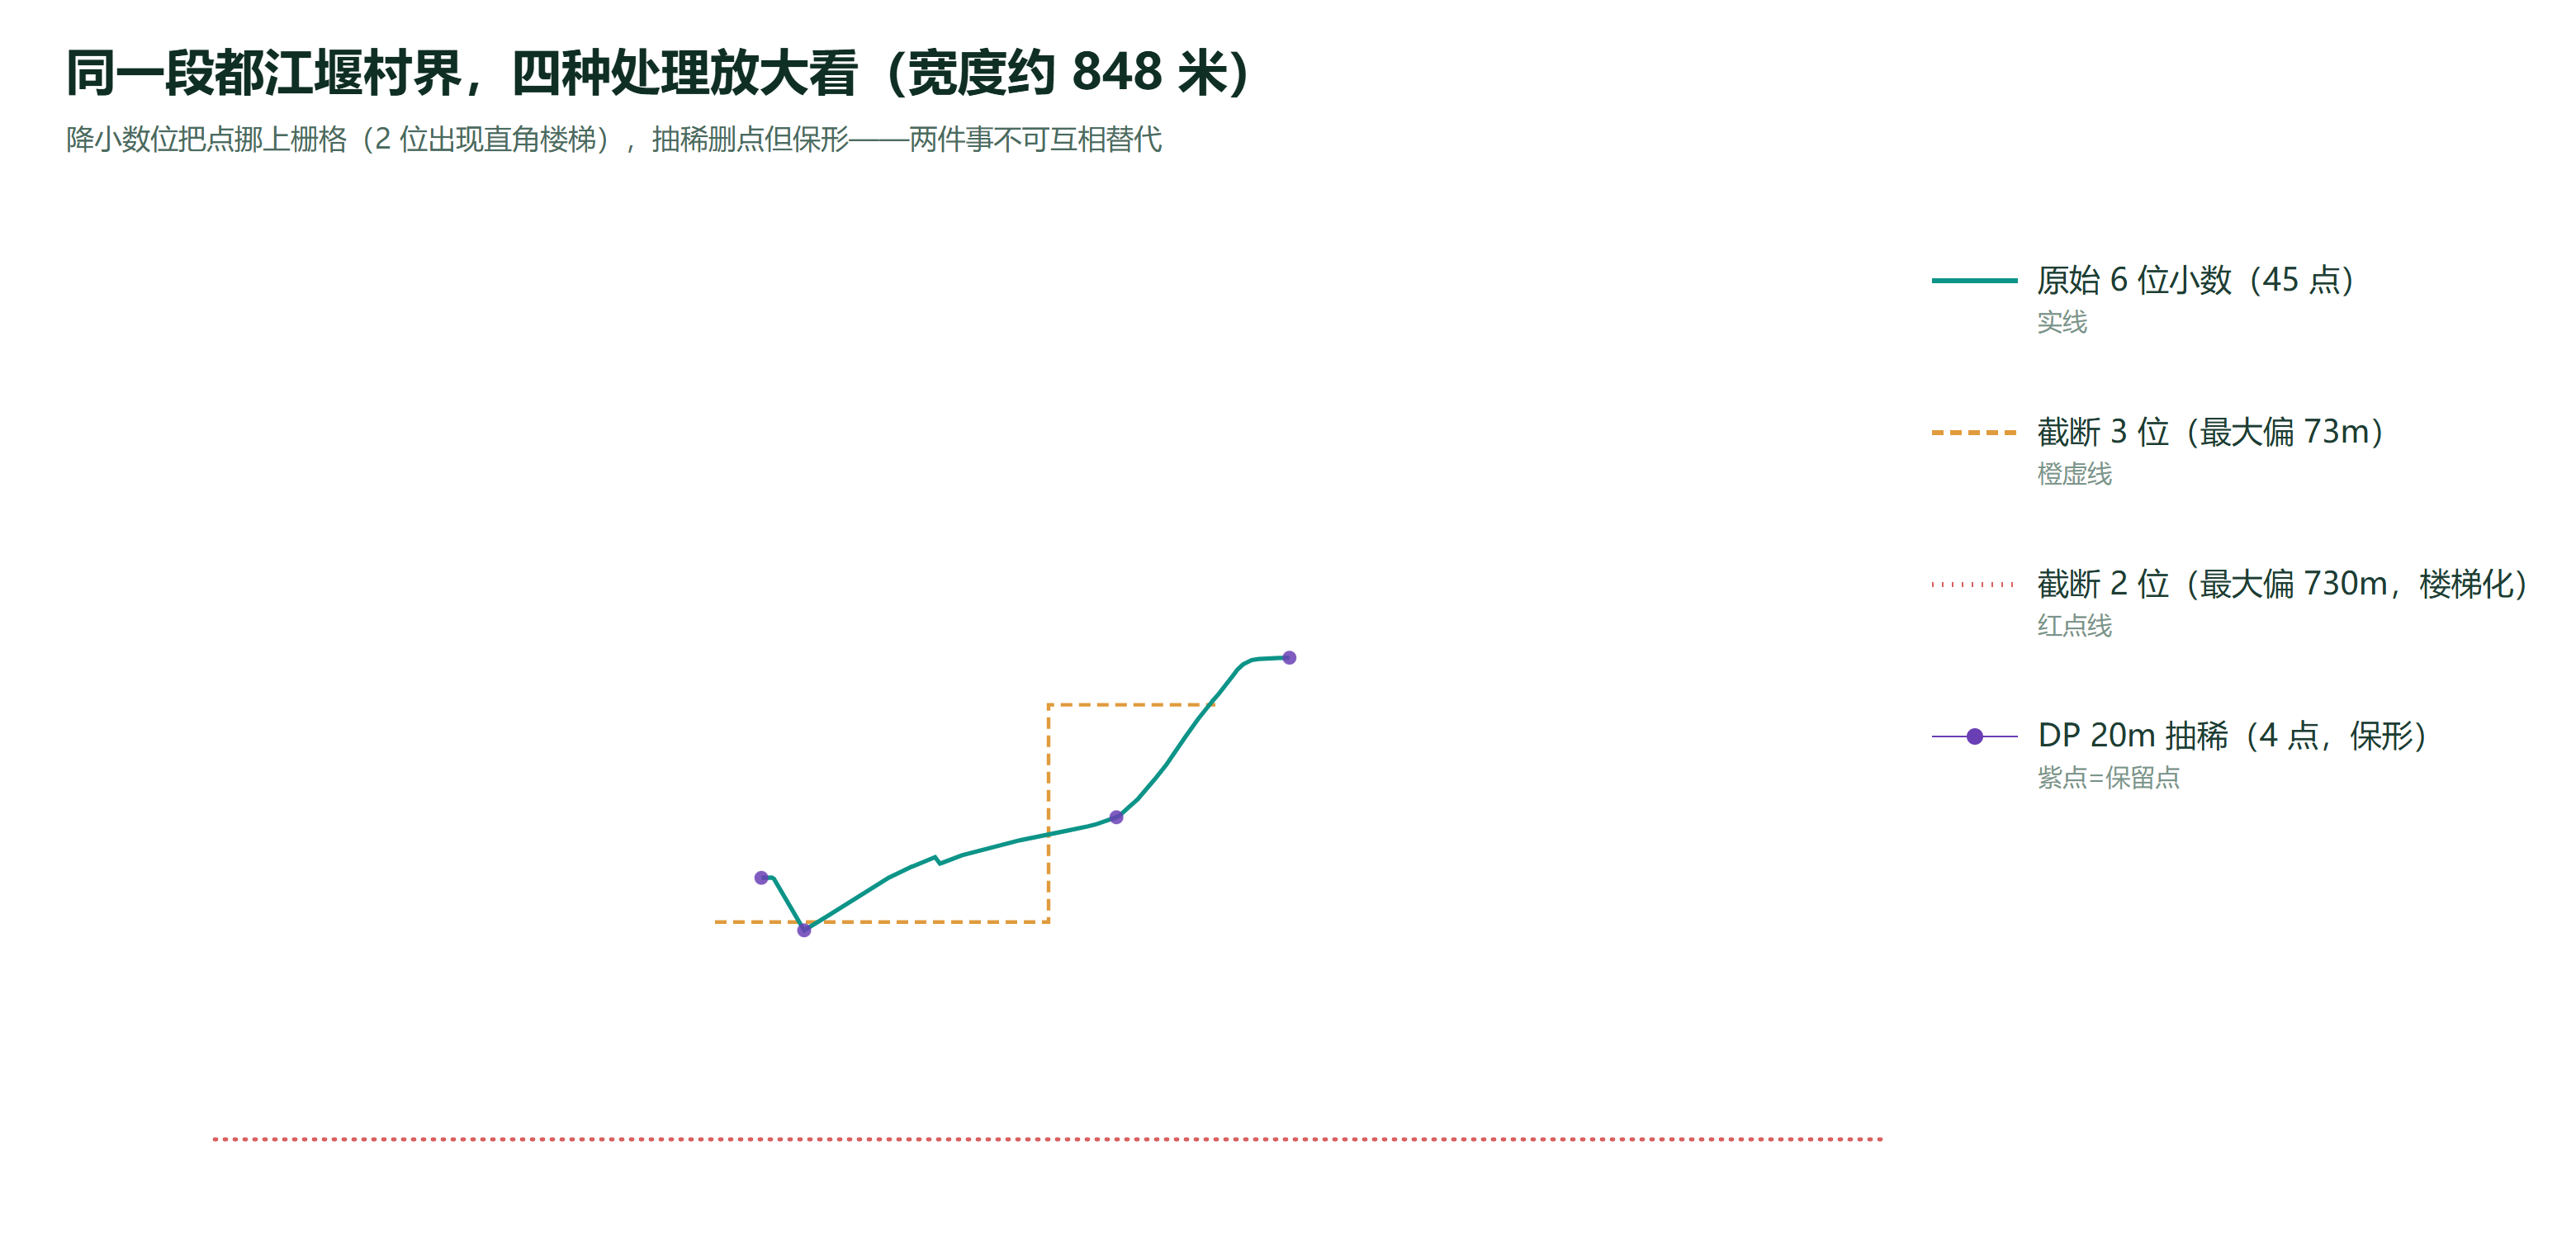
抽稀的代码不长,坑却真实:第一版对着闭合环直接跑,任意容差都把环删到只剩端点——原因是闭环首尾重合,DP 的基线弦长度趋近于零,垂直距离全部失真。修法是先找距首点最远的点当第二锚点,把环拆成两段开链:
function dpRing(ring, eps) {            // eps 单位:米
  const n = ring.length;
  let far = 1, fd = -1;                  // 找距首点最远的点做第二锚点
  for (let i = 1; i < n; i++) {
    const d = distM(ring[0], ring[i]);
    if (d > fd) { fd = d; far = i; }
  }
  const keep = new Uint8Array(n);
  keep[0] = keep[far] = 1;
  const stack = [[0, far], [far, n - 1]]; // 拆两段开链,分别 DP
  while (stack.length) {
    const [s, e] = stack.pop();
    let maxD = 0, idx = -1;
    const dx = (ring[e][0] - ring[s][0]) * 111320 * K, dy = (ring[e][1] - ring[s][1]) * 110540;
    const L = Math.hypot(dx, dy);
    for (let i = s + 1; i < e; i++) {
      const d = L > 1e-9
        ? Math.abs(dy * (ring[i][0] - ring[s][0]) * 111320 * K - dx * (ring[i][1] - ring[s][1]) * 110540) / L
        : distM(ring[s], ring[i]);       // 基线过短时退化为点到点距离
      if (d > maxD) { maxD = d; idx = i; }
    }
    if (maxD > eps && idx > 0) { keep[idx] = 1; stack.push([s, idx], [idx, e]); }
  }
  return ring.filter((_, i) => keep[i]);
}
量化截断的核心循环更简单,但两件事一起做时顺序固定:先抽稀、再降位。反过来先量化到 3 位,等于强行给每个点叠加 ≤73 米噪声,DP 会把这些噪声当成「细节」保留下来。
落地清单:哪种场景动哪一刀
| 场景 | 做法 | 实测依据 |
|---|---|---|
| 交付与存档 | 保持 6 位原样,只做 gz | 10.18MB;降位省的钱对应真实误差 |
| Web 前端展示 | DP 10–20m + 保留 5 位 | gz 1.4–1.8MB,偏移受控在容差内 |
| 统计分析、面积计算 | 不动几何 | 3 位小数的 73m 偏移足以带偏村级面积 |
| 小比例尺示意图 | 可截断 3 位 | gz 1.22MB;读者在小比例尺下分辨不出 73m |
本文实测用的成都市村界包在村界数据 · 按市页可取,全球各级边界在全球行政区划线;文件格式本身的取舍见《GeoJSON 与 Shapefile 怎么选:结构、编码与场景对照》,拿到的数据要裁剪或按县拆分见《从全国边界数据中提取指定省市区县:三种做法》,加载进 ECharts 前的其余准备见《ECharts 地图数据准备》。
常见问题
- GeoJSON 文件太大怎么变小?
- 先删点,再降精度。体积的大头是坐标点个数而不是小数位数:实测成都市村界包 184 万个点占满 40.76MB,降小数位到 3 位只省 26%,而道格拉斯-普克抽稀按 20 米容差删掉 83% 的点、体积省 82%。展示用途先抽稀,交付存档保持原样。
- GeoJSON 坐标保留几位小数合适?
- 看用途定。经纬度第 4 位小数对应约 7 米、第 3 位约 73 米的量化误差(纬度 30° 附近实测)。交付与存档保持数据原样;Web 展示抽稀后保留 4 位以上足够;只在小比例尺出图时才考虑 3 位。2 位小数栅格间距约 1 公里,村市级边界会直接变形。
- 降小数位和抽稀有什么区别?
- 降小数位是把每个点挪上栅格,点数不变,误差均匀分布且不可控地出现在最细的细节上;抽稀(如道格拉斯-普克)按容差删除冗余点,保留下来的点位置不变,形状误差受控在容差内。放大看,2 位小数会让斜线变成直角楼梯,抽稀不会。两者不互相替代,先抽点、再按需降位。
- 压缩包还很大,降小数位能省多少?
- gz 交付口径下收益比解压后的 JSON 更大,因为量化后的坐标重复模式暴增。实测成都市村界包:解压后 JSON 从 40.76MB 降到 30.19MB(省 26%)时,gz 从 10.18MB 降到 1.22MB(省 88%)。但代价是每点 ≤73 米的位置偏移,统计和面积计算都会受影响。
- 自己做抽稀要注意什么?
- 闭合环不能直接跑道格拉斯-普克:首尾点重合导致基线弦长度为零,垂直距离全部失真,实测会出现任意容差都删到只剩端点的情况。正确做法是先找距首点最远的点作为第二锚点,把环拆成两段开链分别抽稀后再合并。面要素还要保留足够点数,避免多环拓扑变形。