填色图配色一次做对:分档、选色与对比度
技术专栏 · 数据可视化 · 2026-10-09
先说一个刚发生的翻车现场。拿 34 个省级单位的村级要素数做一张填色图,颜色映射跑完,山东深绿、河北次深,剩下 32 个省挤在两种浅色里——澳门 11 个村和云南 13,594 个村拿到了同一种颜色。这不是颜色选错了,是分档先出了问题:任何配色方案都救不了错误分档压出来的色阶。这篇把分档和选色两步都用真实数据跑一遍,断点数字、色值、对比度全部给到能直接抄的程度。
数据长什么样,决定分档怎么切
样本是本站 2026-09 批次的村级要素数:34 个省级单位合计 692,801 个村级单元。平均 20,376.5,中位数只有 17,952.5——平均被右侧拉偏,说明分布重尾。实际极值:最小澳门 11,最大山东 85,879,两端差 7,807 倍;最大的山东也是中位数的 4.78 倍。做填色图之前把这个分布画出来(或者至少把这几个统计量算出来),分档方法就已经选定了一半。
三种常用分档的口径:等距把最小值到最大值切成等宽区间;分位数保证每档成员数相等;自然断点(Fisher-Jenks)穷举所有切法,取类内离差平方和最小的那组。分位数和自然断点的核心代码不长,本文实验就是用这段跑的:
// 分位数:34 个值分 5 档,取排序后第 7、14、20、27 位的值做断点
const breaks = Array.from({length: k-1}, (_, i) => vs[Math.round((i+1)*vs.length/k)]);

// 自然断点:D[i][j] = 前 i 个值分 j 类的最小类内平方和
const wss = (s, e) => (pre1[e+1]-pre1[s]) - (pre2[e+1]-pre2[s])**2 / (e-s+1);
for (let i = 1; i <= n; i++)
  for (let j = 1; j <= Math.min(k, i); j++)
    for (let t = 1; t <= i; t++)
      if (D[t-1][j-1] + wss(t-1, i-1) < D[i][j]) {
        D[i][j] = D[t-1][j-1] + wss(t-1, i-1);
        B[i][j] = t;                    // 记边界,回溯时逐类往回走
      }
// 注意断点本身是某个省的真实数值,归属判断用 v > break 归上一档,
// 用 v >= break 会把断点值划进下一档——第一版就是这样把河北归错档的
三种方法对同一组数据各切了一刀,结果摆在一张图里看差距:
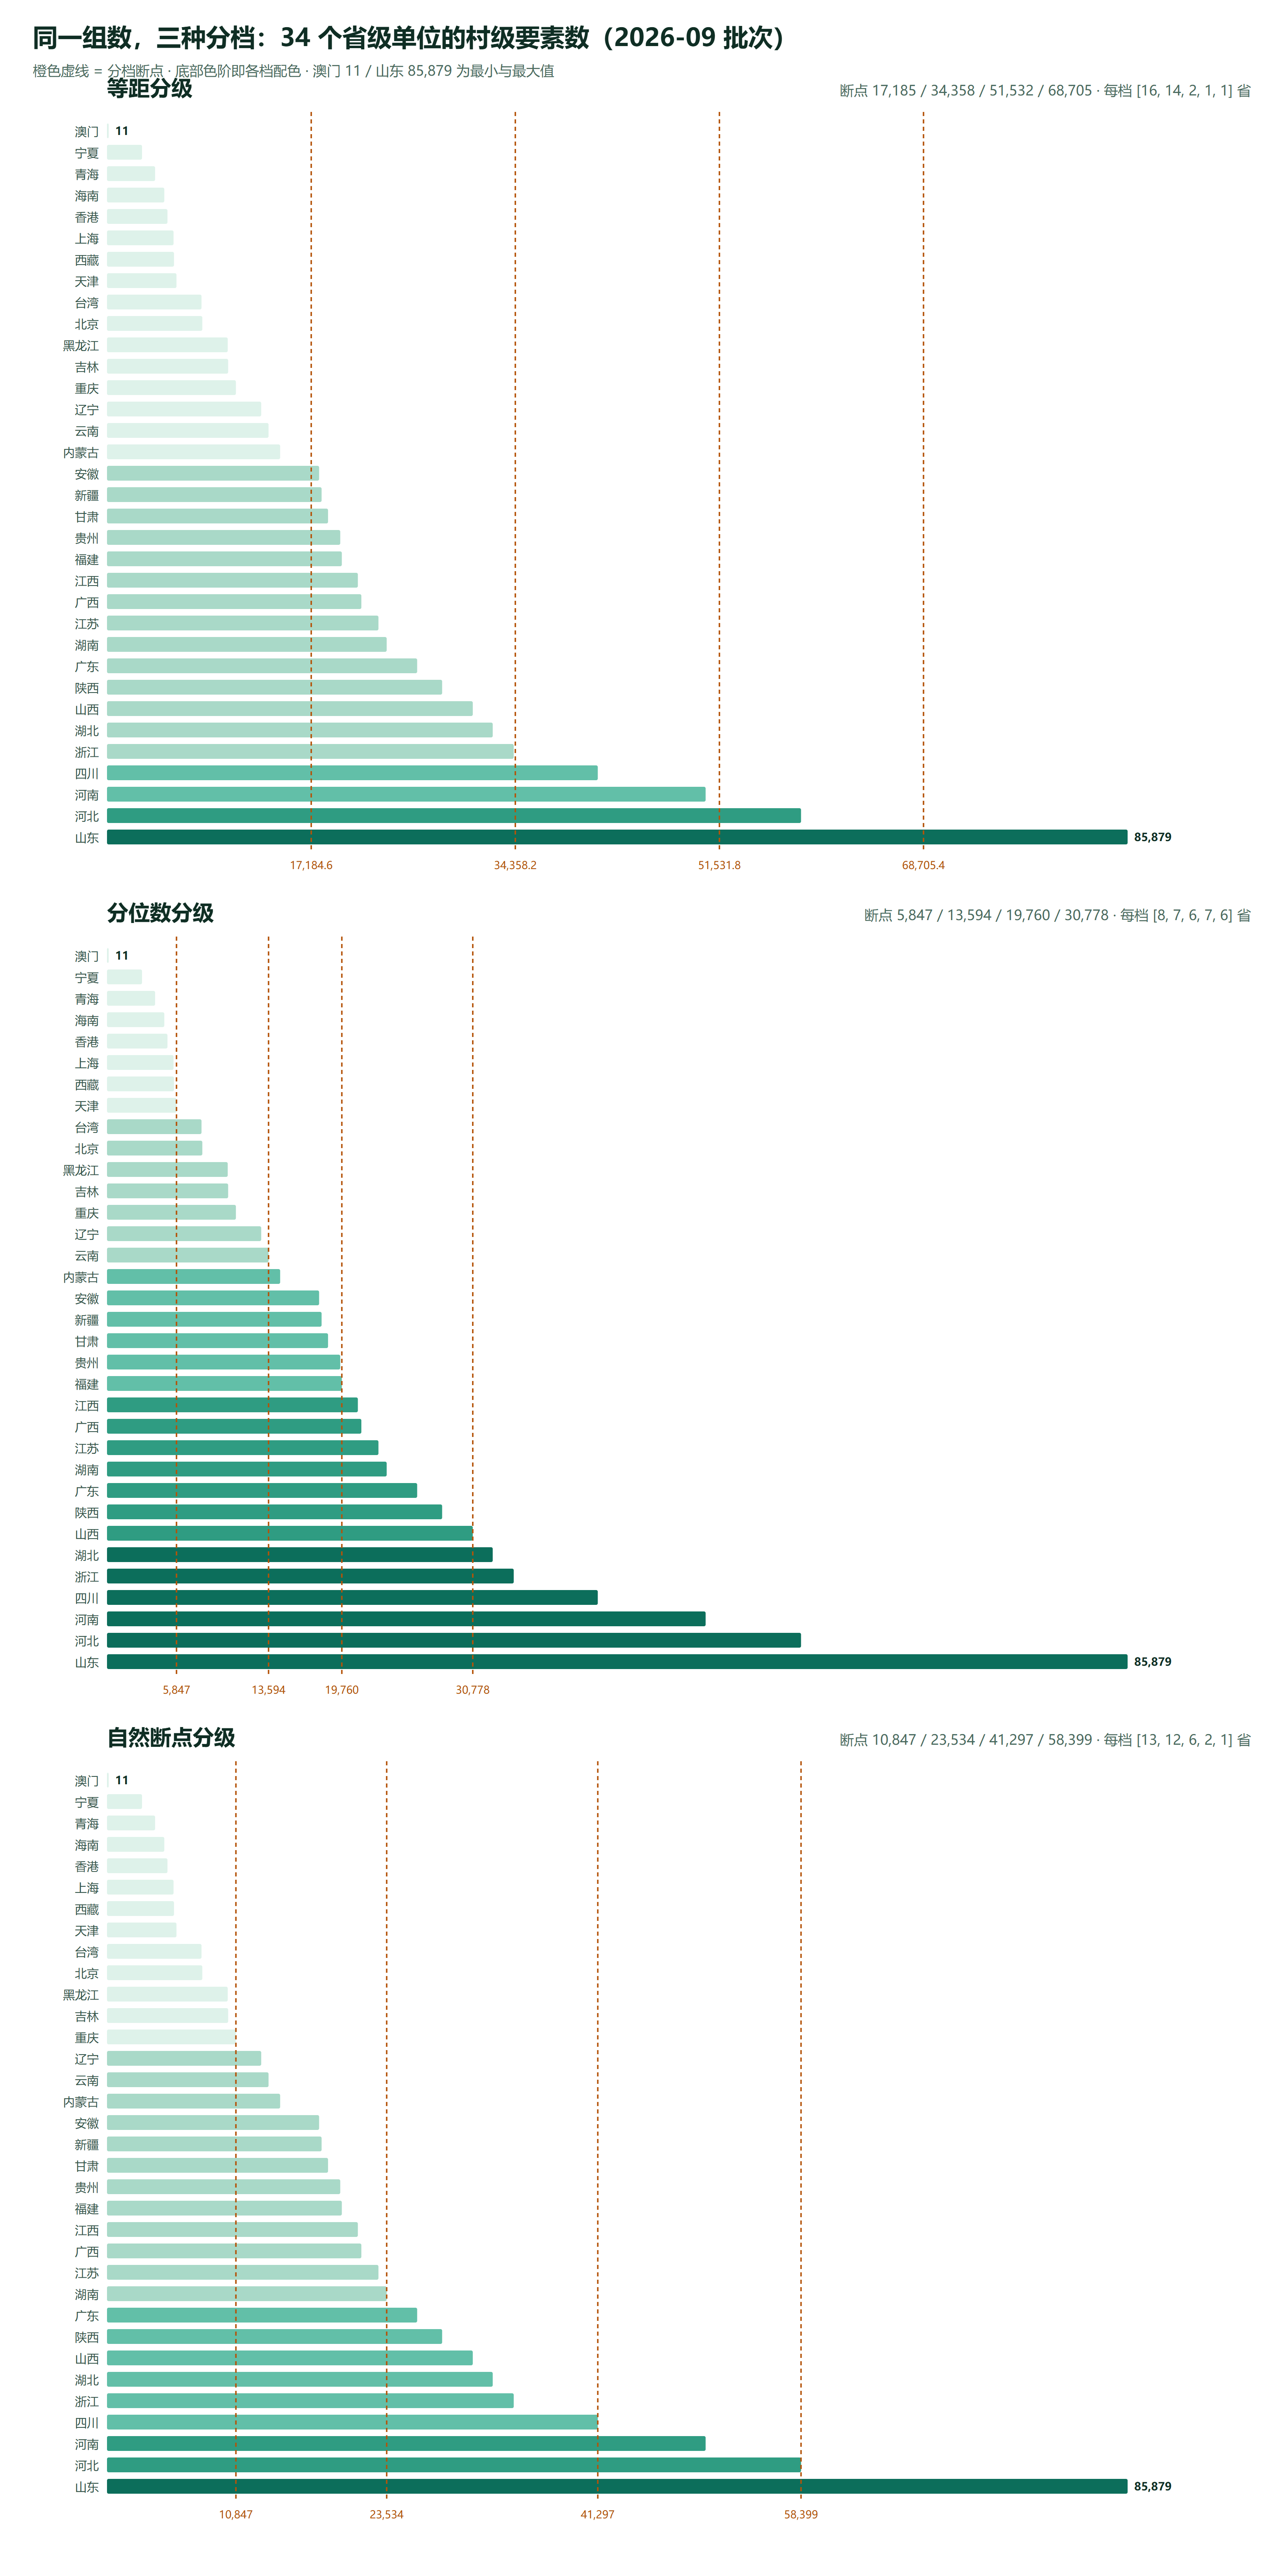
三种分档各错在哪,数字说话
把 5 档结果摊开对比,每种方法的短板都不一样:
| 方法 | 断点 | 每档省数 | 拟合优度 GVF | 实际效果 |
|---|---|---|---|---|
| 等距 | 17,184.6 / 34,358.2 / 51,531.8 / 68,705.4 | 16, 14, 2, 1, 1 | 0.9337 | 第一档塞进 16 个省,澳门 11 与云南 13,594 同色;河北、山东各自独占一档 |
| 分位数 | 5,847 / 13,594 / 19,760 / 30,778 | 8, 7, 6, 7, 6 | 0.7959 | 每档人数齐整,但顶档从 32,457 横跨到 85,879,浙江和山东差 2.5 倍还是同色 |
| 自然断点 | 10,847 / 23,534 / 41,297 / 58,399 | 13, 12, 6, 2, 1 | 0.9596 | 断点落在数据缝隙上;顶上两档只剩河南、河北、山东三省,图例需要点名 |
有一个反直觉的数字值得单独说:等距的 GVF 高达 0.9337,只比自然断点低两分多。如果只拿拟合度当评分标准,等距几乎是合格——可它第一档里澳门到云南差着 1,300 多倍。GVF 衡量的只是方差有没有被档内消化,它不管图例读起来是什么感受。选分档方法的依据应该是读者的任务:看格局(哪些省多、哪些省少)用自然断点;做排名分队用分位数;数据本身均匀才轮到等距。
档数加到几档为止
自然断点从 4 档加到 6 档,GVF 分别是 0.9237、0.9596、0.9751。第 5 档带来的增益比第 4 档小,第 6 档更小,这就是收益递减的形状。图例那头的成本却在涨:6 档以上,读者要在图面上逐格比对六种相近色,出错率肉眼可见地上升。这组数据的取舍是 5 档——顶档只剩山东一个省不是缺陷,它本来就是离群点,图例写明「山东 85,879」比硬把它和河北凑成一档更诚实。
色阶:机器插值不如手工校一遍
分档定了,轮到颜色。直觉做法是让程序在起止色之间等距插值,本文试了两只程序生成的青绿梯(HSL 等距插值、非线性插值),再用 CIELAB 明度差 ΔL* 逐对实测相邻档,结果都不合格:等距插值前两档 ΔL* 只有 9.1 和 8.3,非线性插值更糟,浅端两档 6.7——人眼对浅色的分辨本来就弱,这一挤,头两档在图上就是同一种颜色。最后采用的五档是手工定档后逐对校出来的:
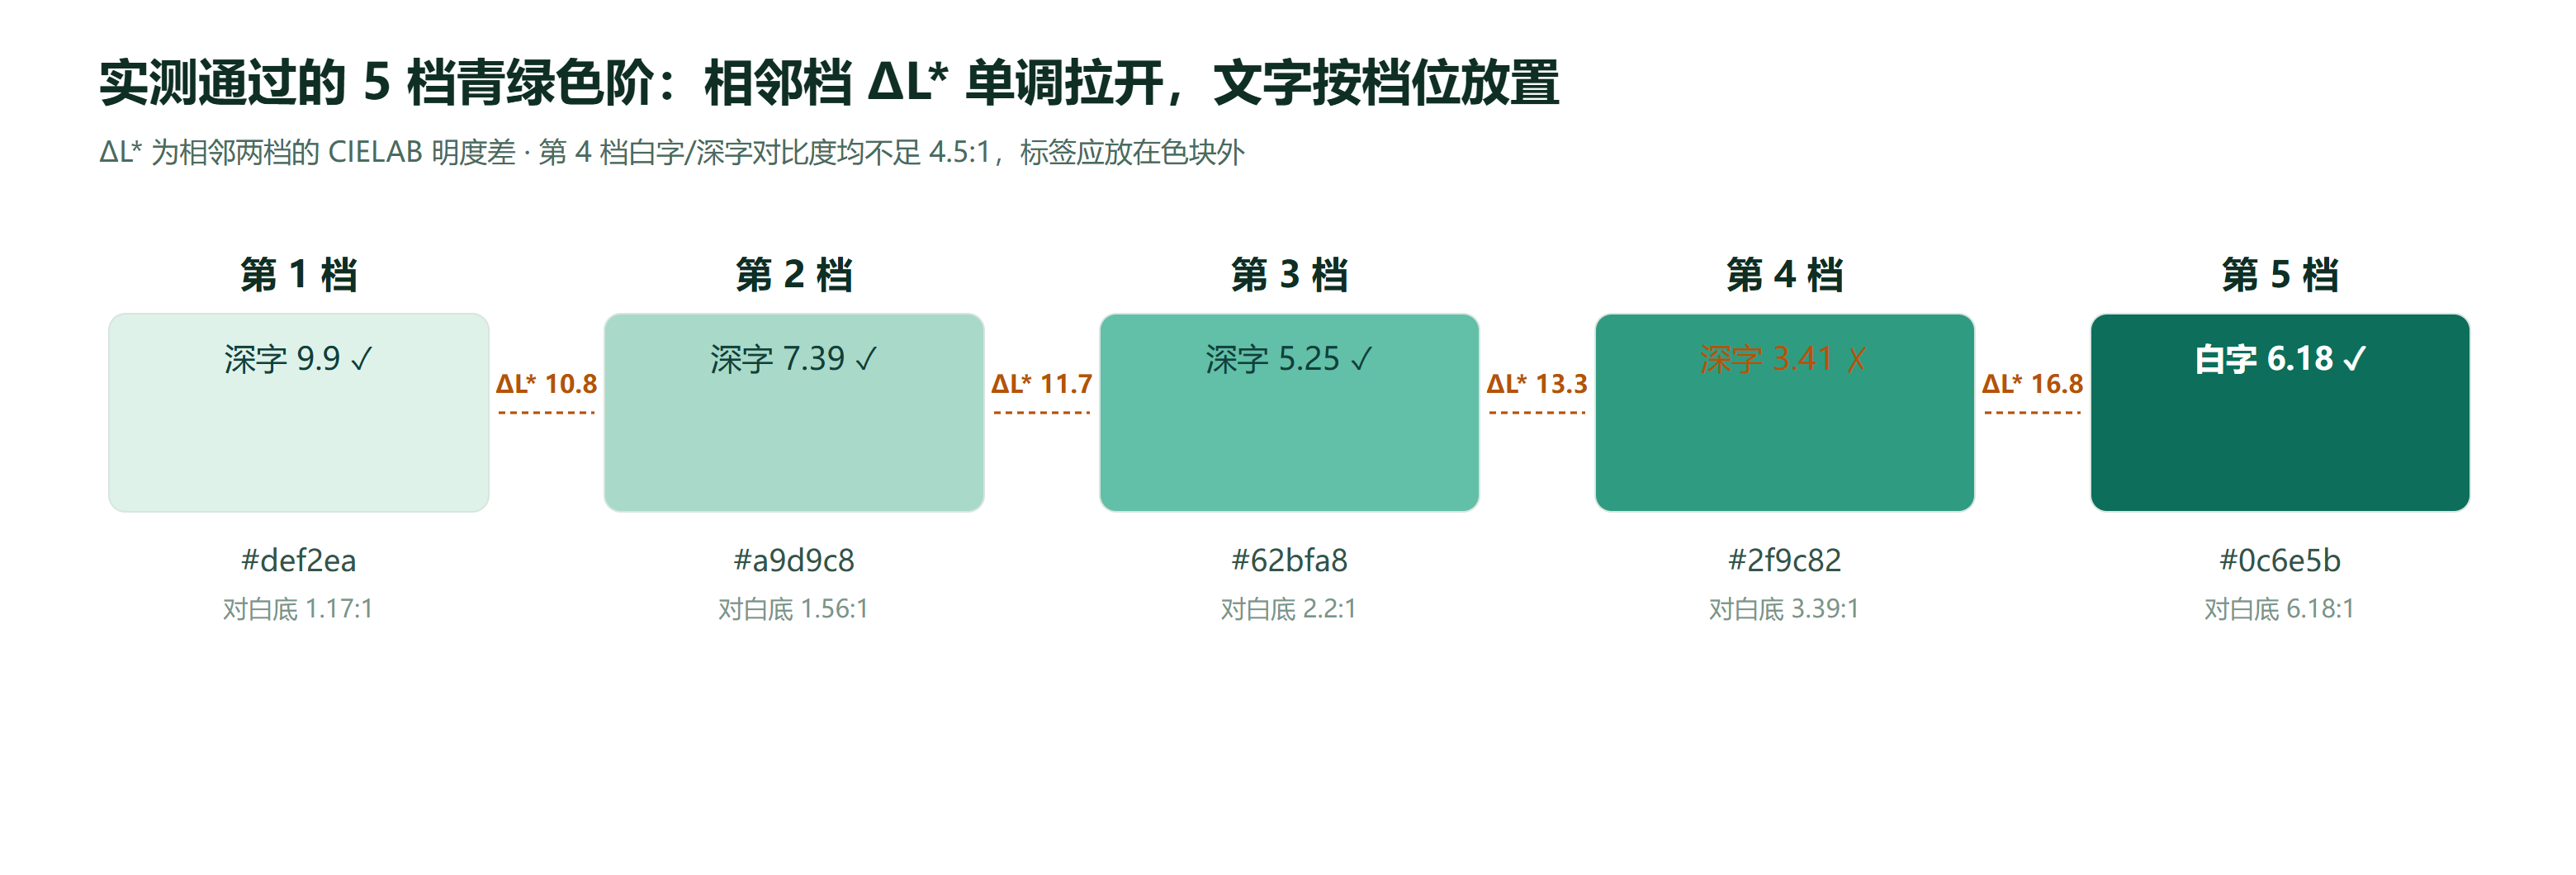
文字放置也有数字可依。前 3 档配深青文字(#11403a),对比度 9.9 : 1、7.4 : 1、5.3 : 1,都过 4.5 : 1 的正文标准;第 4 档 #2f9c82 麻烦——白字 3.39 : 1、深字 3.41 : 1,两头都不达 4.5 : 1,中间明度的色块天生放不了字,标签只能画在色块外。第 5 档 #0c6e5b 配白字 6.18 : 1,没问题。这条检查在换任何色系时都要重做一遍,明度动一处,全组数字跟着变。
落进 ECharts:pieces 数组直接抄
ECharts 的 visualMap 选 piecewise 模式,pieces 由上面实测的断点和色值生成。这份配置的数值边界与归属口径和本文实验完全一致(断点值归上一档,所以每档用 gt 接上界、lte 压下界):
visualMap: {
  type: 'piecewise',
  pieces: [
    { lte: 10847, color: '#def2ea', label: '澳门 11 ~ 重庆 10,847' },
    { gt: 10847, lte: 23534, color: '#a9d9c8', label: '辽宁 12,976 ~ 湖南 23,534' },
    { gt: 23534, lte: 41297, color: '#62bfa8', label: '广东 26,099 ~ 四川 41,297' },
    { gt: 41297, lte: 58399, color: '#2f9c82', label: '河南、河北' },
    { gt: 58399, color: '#0c6e5b', label: '山东 85,879' }
  ]
}
连续型 visualMap 在这组数据上不要用:11 到 85,879 拉成一条色带,超过四成的省落在最底端约六分之一的区间里,回到开头那翻车的图。GeoJSON 从哪来、注册前要处理什么,见《ECharts 地图数据准备》;三条制图路线的整体取舍见《行政区划填色图制作指南:ECharts、Leaflet 与 PPT 三条路线》。
三个高频坑,都是跑一遍才看得见的
极值压扁色阶。澳门 11 不是误差,是真实的 7,807 倍极差。等距档对这种分布无能为力,处理办法只有两种:极值单独成档并在图例写明数值,或者改对数间距。装作看不见极值,色阶必然失真。
断点值归属。自然断点的断点取自真实数据(58,399 是河北),写分类函数时 v > break 归上一档、v >= break 归下一档,一字之差,河北就从第 4 档掉进空档。ECharts 的 gt/lte 写法把这件事显式化了,自己手写循环时最容易在这里栽。
只看 GVF 定档。等距 0.9337 的拟合度看着体面,挡不住 47% 的省挤一档。拟合度是必要条件不是充分条件,定档最后一步永远是回到图上问一句:这个颜色分布讲出来的故事和数据一致吗?
常见问题
- 填色图分几档合适?
- 4 到 6 档之间。档数带来的分辨力是递减的:同一组 34 个省级数据,自然断点法从 4 档加到 5 档,类内离差平方和的拟合优度从 0.9237 涨到 0.9596;加到 6 档只再涨到 0.9751。超过 6 档,图例逐档辨认颜色已经吃力,读者不会逐格比对。拿不准就从 5 档起试。
- 等距、分位数、自然断点,分档方法到底用哪个?
- 先看数据分布再定。数据均匀或有天然上下限(如百分比),等距最直观;读者任务是排名分队(前 1/4、中位数这一类口径),用分位数;数据重尾、被少数大值拉偏,用自然断点。本文的省级村级要素数就属于第三种:最小 11、最大 85,879,等距分级把 47% 的省塞进同一档,自然断点顺着数据缝隙切,拟合优度 0.9596 为三种方法里最高。
- 相邻两档颜色分不清怎么办?
- 用 CIELAB 明度差 ΔL* 校验相邻档位,实测低于 10 就拉开明度或减少档数。本文对比过两种生成方式:HSL 等距插值出的色阶前两档 ΔL* 只有 8.3,曲线插值更低到 6.7,而手工定档并逐档校验的色阶做到 10.8、11.7、13.3、16.8 递增。颜色是给图例和图面共用的,浅端最容易挤在一起,定完色阶必须逐对检查。
- ECharts 用连续型还是分段型 visualMap?
- 数据重尾时用分段型 piecewise。连续型把最小值到最大值拉成一条色带,本文这组数据最小 11、最大 85,879,超过四成的省落在色带最底端约六分之一的区间里,肉眼几乎同色。piecewise 配 pieces 数组,每档给 gt/lte 边界和颜色,边界值归属要注意:58,399 这类断点本身是某省的真实数值,用 gt 上一档、lte 本档的写法才不会把它漏掉或重复计档。
- 有极端值时色阶怎么处理?
- 两种做法:极值单独成档,图例直接写明(本文山东 85,879 独占最深一档、澳门 11 落在第一档并在图例标出实际数值);或者改用对数间距分档。不要把极值留在等距档里不管——那会把整个色阶压扁,让大多数单元失去分辨力。
想把这张图做出来,数据直接取用:省级边界在省 / 市 / 区县边界包,村级口径的省份数据在村界数据(按省),文中断点与色值按上文配置即插即用。延伸阅读:《从全国边界数据中提取指定省市区县:三种做法》《省市区县边界数据下载:粒度选择与字段说明》。